Что болело до нас
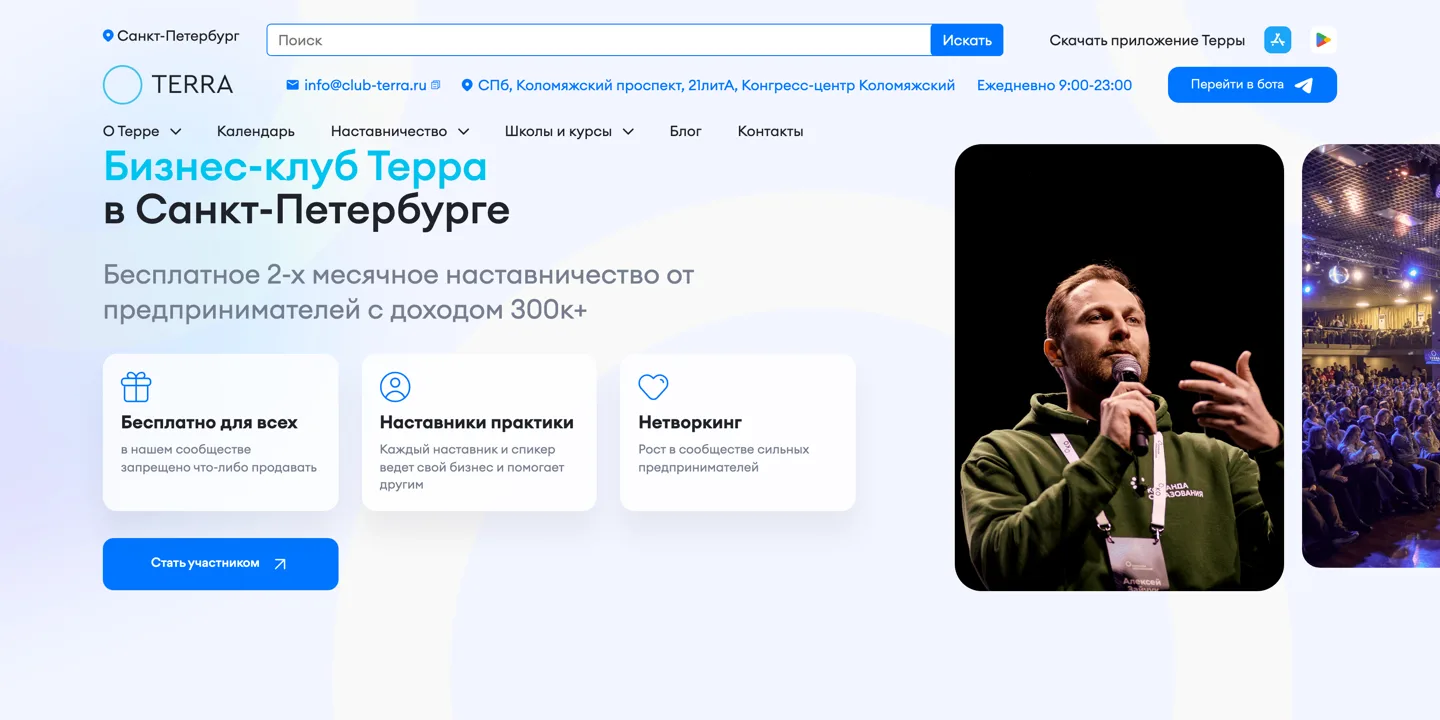
Петербургское отделение бизнес-клуба TERRA жило на общем корпоративном сайте на MODX Revolution. Поддомен был частью московской системы. Отделение не управляло ни контентом, ни заявками: любая правка шла через чужую редакцию и чужие руки.
Содержание разъехалось с реальностью. В каталоге висело 44 школы и 49 наставников. В актуальном списке отделения было 17 школ и 25 наставников. Меню в шапке предлагало 36 старых пунктов.
Отдельная история с заявками. Отклики на вакансии и подписки уходили на обработчик, которого фактически не существовало. Посетитель видел «спасибо», лид не доходил ни до кого. Сколько таких обращений потерялось, посчитать уже нельзя.
Сняли сайт в собственную копию
Написали свой краулер на Python и забрали поддомен целиком: 305 страниц и 436 ассетов, обход занял около 17 минут. Дальше пост-обработка: переписали base href и 3023 абсолютные ссылки на живой домен.
Проверили копию на утечки по ссылкам, картинкам, скриптам, iframe, стилям, формам и srcset. Обращений к чужому серверу не осталось ни одного. Потом сверили 12 страниц с оригиналом: 11 совпали идеально, на двенадцатой не хватало трёх иконок. Сплошной второй проход нашёл ещё 23 недостающих файла, 21 из них удалось забрать.
В формах старой CMS осталось четыре скрытых поля от антиспама. Три работают как обычно: человек их не заполняет, бот заполняет. Четвёртое устроено наоборот. Скрипт сайта сам пишет туда значение через полторы секунды после загрузки, поэтому заполненное поле означает живого посетителя с браузером. Мы приняли его за обычную ловушку и стали отсекать настоящих людей. Форма отвечала «Спасибо, заявка принята», в базу не попадало ничего. Нашли сквозным тестом на боевом сайте, по коду это было не видно. Решение приняли осознанно: по этому полю не отсеиваем никого. Потерянный лид дороже лишнего спама. Проверили на четырёх сценариях: человек с JS, человек без JS, два вида ботов.
Каталоги стали данными
Динамика старой CMS в статике не живёт: поиск, фильтры и пагинация остались на московском сервере. Мы пересобрали каталоги школ и наставников на своих генераторах. Карточки лежат отдельными файлами в репозитории, страницы и листинги собираются скриптами.
Потом сверили сайт с актуальной таблицей отделения. Создали 8 новых страниц школ, добавили 13 наставников, 37 устаревших карточек убрали из каталогов. Сами страницы оставили живыми, чтобы не терять позиции в поиске. Меню в шапке сократили с 36 пунктов до 17.
Контент отделение правит само. Поставили лёгкую админку на Sveltia CMS: без сервера и без базы, изменения идут коммитами в репозиторий. Включён режим согласования, правка помощника ждёт подтверждения владельца.
Заявки перестали пропадать
Написали маленький сервис приёма заявок на стандартной библиотеке Python: 449 строк, ноль внешних зависимостей. Он принимает форму, кладёт лид в файловую базу и показывает его в простой панели под логином. Есть статусы «Новая», «В работе», «Обработана», заметки и выгрузка в CSV. По желанию дубль уходит в Telegram.
Формы переключили на него на 327 страницах. Заодно сделали клиентский поиск по сайту на 328 записей, взамен серверного поиска старой CMS.
Где споткнулись
Сами формы не отправлялись. Штатный AJAX старой CMS требовал jQuery-плагин, которого в копии не было. Клик по кнопке перезагружал страницу и отдавал техническую ошибку. Написали свой обработчик на чистом JS, 40 строк, без зависимостей.
Молча не срабатывала подстановка мета-тегов. Регулярное выражение в генераторах ждало атрибуты в одном порядке, разметка отдавала в другом. В итоге каноническая ссылка каталогов указывала на чужую страницу-донор, а все 17 школ получили одинаковое описание. Поисковик счёл бы каталоги дублями и выбросил из индекса. Вылечили заменой тега целиком: порядок атрибутов перестал иметь значение. Правка вышла на 5 генераторов и 7 мест.
Пересобирая школы из таблицы, мы единым шаблоном перезаписали 9 страниц с живым текстом, накопленным годами. Минус 84-89% содержания на страницах, которые уже сидели в поиске. Заметил владелец фразой «школы какие-то пустые». Восстановили посимвольно и ввели правило: если у страницы есть оригинал, обновляем только мета-теги и дату ближайшего потока, тело оставляем как есть. Заодно сняли бэкап всех 43 оригинальных страниц школ со старого сервера, пока его не выключили.
Тихая грабля: 34 страницы школ и курсов выпали из каталога. Живые, в карте сайта, но ни одной внутренней ссылки на них не вело. Такое не видно ни глазом, ни в браузере, нашли сверкой со старой версией и подняли перелинковку с 22 ссылок до 65. Рядом обнаружился генератор главной, который с июля по август отрабатывал вхолостую: он искал блок старой CMS, который сам же и заменил при первом запуске. Вывод простой. Генератор должен уметь узнавать собственный результат, иначе он одноразовый.
Как сайт живёт сейчас
Сайт целиком статический: готовые HTML, CSS, картинки и шрифты, которые отдаёт обычный веб-сервер. На публичном контуре нет базы, админки и бэкенда, поэтому ломать там почти нечего, а страницы открываются мгновенно.
Меняющийся контент хранится текстовыми файлами в репозитории, это источник истины. Правка через браузер запускает автосборку: девять генераторов заново собирают страницы школ, каталог наставников, ленту блога, меню, баннер ближайшего потока и подборки на главной. Сервер подхватывает выкладку за пару минут.
Под переезд отдельно проработали SEO: карта сайта на 313 живых URL, robots с разрешением для AI-краулеров, llms.txt с фактами для цитирования нейросетями, разметка JSON-LD и уникальные описания. Плюс отдельный лендинг под QR-трафик с мероприятий. Проект на постоянном ведении, в репозитории 92 коммита, следующая задача уже описана: передача лидов в систему головной организации.
Частые вопросы
Можно ли перенести сайт с чужой CMS на свой хостинг?
Да, если сайт отдаёт готовые страницы. Мы написали свой краулер на Python и забрали поддомен целиком: 305 страниц и 436 ассетов, обход занял около 17 минут. Дальше переписали base href и 3023 абсолютные ссылки на живой домен. После проверки по ссылкам, картинкам, скриптам, iframe, стилям и формам обращений к чужому серверу не осталось ни одного.
Почему заявки с сайта не приходят, хотя форма пишет «спасибо»?
Частая причина: форма шлёт данные на обработчик, которого уже нет. У петербургской TERRA так уходили отклики на вакансии и подписки, посетитель видел «спасибо», лид не доходил ни до кого. Вторая причина тоньше: скрытые антиспам-поля, которые отсекают живых людей. По коду это не видно, ловится только сквозным тестом на боевом сайте.
Как принимать заявки с сайта без CRM?
Мы написали маленький сервис приёма заявок на стандартной библиотеке Python: 449 строк, ноль внешних зависимостей. Он принимает форму, кладёт лид в файловую базу и показывает его в панели под логином. Есть статусы «Новая», «В работе», «Обработана», заметки и выгрузка в CSV. По желанию дубль уходит в Telegram.
Как редактировать статический сайт без программиста?
Контент лежит текстовыми файлами в репозитории, это источник истины. Поставили лёгкую админку Sveltia CMS: без сервера и без базы, правка из браузера идёт коммитом. Дальше автосборка пересобирает страницы девятью генераторами, сервер подхватывает выкладку за пару минут. Включён режим согласования, правка помощника ждёт подтверждения владельца.
Что будет с позициями в поиске после переноса сайта?
Позиции держатся, если старые URL остаются живыми. Мы убрали 37 устаревших карточек из каталогов, но сами страницы не удаляли. Отдельно починили канонические ссылки и описания: из-за ошибки в генераторах все 17 школ получили одинаковый текст, поисковик счёл бы каталоги дублями. Итог переезда: карта сайта на 313 живых URL, разметка JSON-LD, robots с разрешением для AI-краулеров и llms.txt с фактами для цитирования.


